專案背景
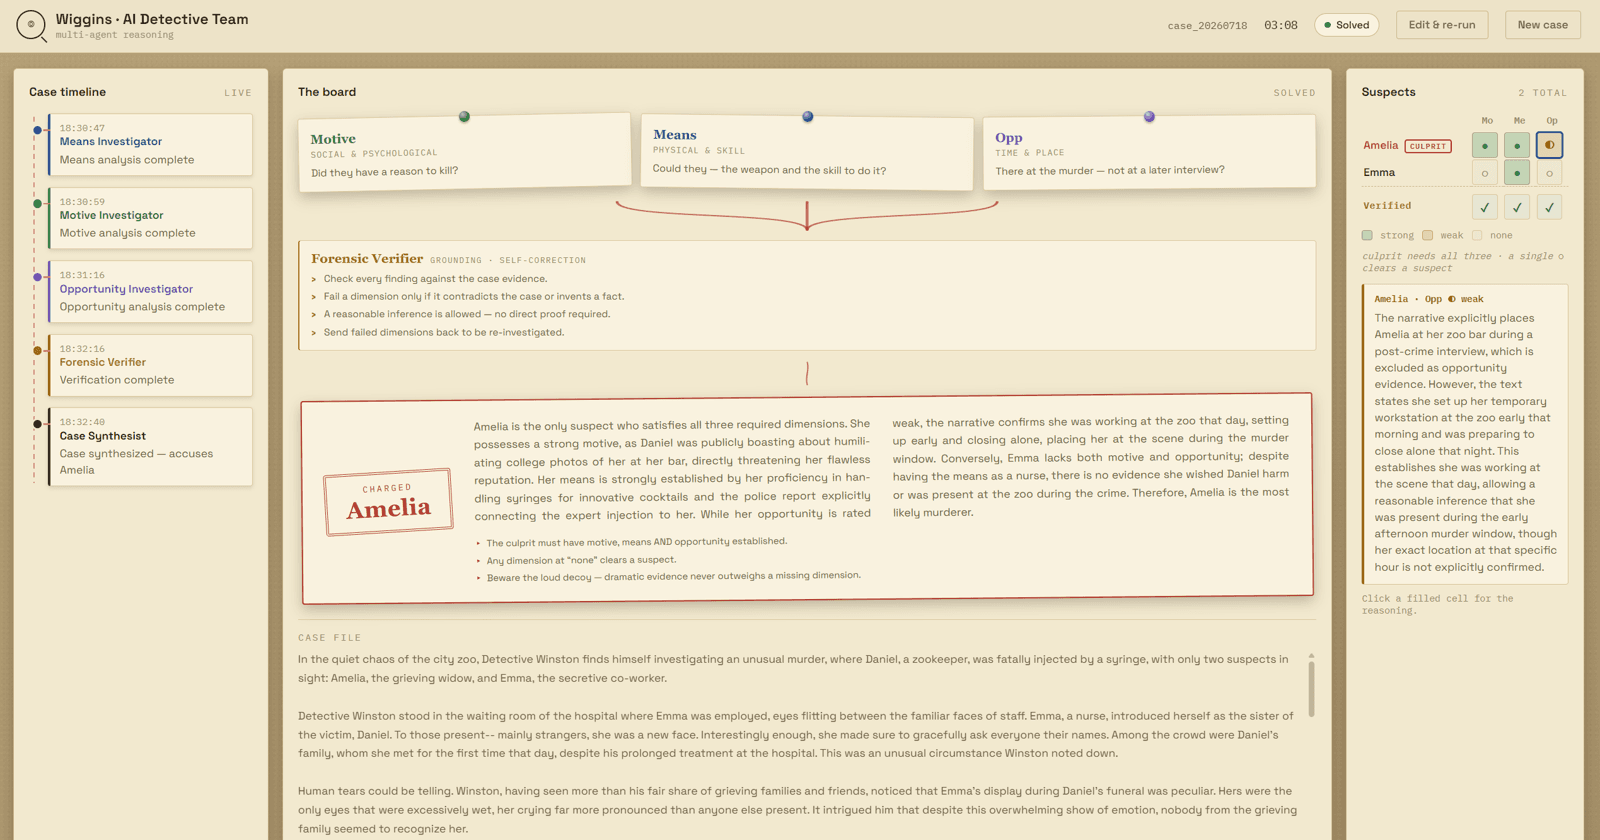
Wiggins 是我和 kencsie 一起參加 Global AI Hackathon Series with Qwen Cloud 做的多 Agent 推理系統。使用者可以輸入一段案件敘述、嫌疑人和問題,系統會讓多個 AI 偵探分頭調查,最後給出裁決。題目來自 MuSR 資料集的謀殺推理題,每題有兩名嫌疑人。
我們把開發和評測過程寫成技術文章,拿到了 Blog Post Award(500 美金):
- 📝 得獎文章:Our Multi-Agent System Got 9 More Cases Right, but We Weren't Satisfied
- 🏆 Devpost 頁面:Wiggins · AI Detective Team
- 🎬 Demo 影片:YouTube
系統架構
案件敘述 │ ├─▶ 動機調查員 (Motive) ─────┐ ├─▶ 手段調查員 (Means) ──────┼─▶ 鑑識驗證員 ──▶ 主任偵探 └─▶ 機會調查員 (Opportunity) ┘ (把每條發現對回 (綜合裁決) ▲ 原文,不通過就重查) └──────── 重查 ─────────┘- 後端:FastAPI + LangGraph 編排流程,模型使用 Qwen Cloud(Alibaba DashScope)
- 串流:調查過程透過 SSE 即時推送到前端
- 部署:Alibaba Cloud ECS 上用 Docker Compose 跑 nginx + API
我負責的部分:前端偵探板
我的工作是把 Agent 的推理過程呈現出來,讓使用者看得到每個偵探在想什麼,並得出最後的答案:
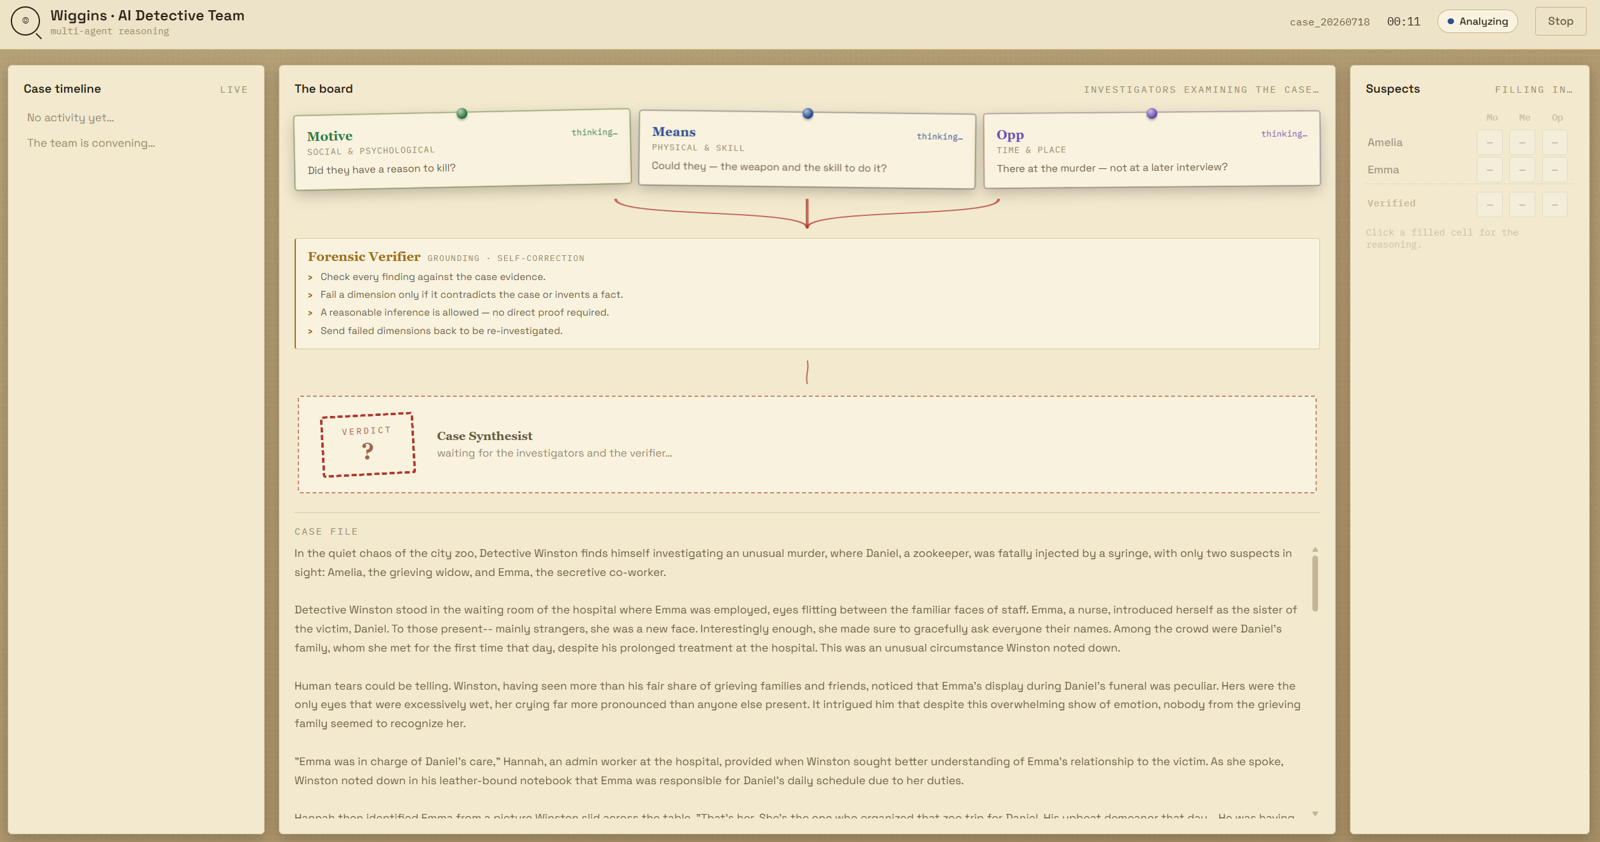
- Evidence Board:軟木板 + 紅線的視覺風格,把線索和嫌疑人連起來
- 即時推理展示:三個調查員並行思考的動態效果,以及時間軸
- 三級強度矩陣:每位嫌疑人在動機/手段/機會上被評為 strong、weak 或 none
- 自我糾錯可視化:驗證員要求重查時顯示重查橫幅和自我糾錯徽章
- 裁決橫幅:最後的結案判決
- 另外也補了
/health端點、CI 的前端 build,以及 dev/deploy 輔助腳本
評測結果
| 測試集 | Wiggins(多 Agent) | 單次呼叫 baseline |
|---|---|---|
| 最難的 20 題 | 16/20 | 10/20 |
| 完整乾淨集(92 題) | 87/92(94.6%) | 78/92(84.8%) |
在完整測試集上,Wiggins 比 baseline 多答對 9 題。
但我們沒有停在「多 Agent 比較強」這個結論。對照實驗發現,如果把同樣三條推理規則加進單次呼叫的 prompt 後,baseline 在困難集上就從 10/20 進步到 15/20。所以準確率的提升主要來自規則,不是架構。 多 Agent 架構價值在於當成「顯微鏡」:一次只看一個維度,比較容易找出模型錯在哪裡,進而歸納出這些規則。
技術細節:用 fetch 自己解析 SSE
後端的 /analyze/stream 是 POST(要把整段案件敘述送上去),但瀏覽器內建的 EventSource 只支援 GET,所以我改用 fetch 讀 ReadableStream,自己把位元組切成一行一行的 data: 事件:
const reader = res.body.getReader();const decoder = new TextDecoder();let buffer = "";while (true) { const { done, value } = await reader.read(); if (done) break; buffer += decoder.decode(value, { stream: true }); const lines = buffer.split("\n"); buffer = lines.pop() ?? ""; // 最後一行可能還沒傳完,留到下一輪 for (const line of lines) { if (!line.startsWith("data: ")) continue; applyEvent(JSON.parse(line.slice(6))); }}網路封包不會剛好在換行處切開,buffer = lines.pop() 這行就是在處理「半行」的情況。搭配 AbortController,使用者按 Stop 或 Edit & re-run 時可以馬上中斷串流。
為了讓前後端能平行開發的設計:
?mock=1假串流:後端 pipeline 還沒完成時,我先照約定的事件格式寫了一份假劇本,安排一次「手段調查未通過 → 退回重查 → 再通過」,用來開發和 demo 自我糾錯的畫面。- 優雅降級(graceful degradation):強度評級、引用原文這些欄位是後來才加進後端的。前端拿不到時就退回比較簡單的呈現;收不到節點的
start事件時,也會改用流程拓樸推斷「現在誰在思考」,不會整個畫面壞掉。
學習反思
開發後期剛好碰上暑期實習開始,白天上班,我們就利用下班後的時間討論:對齊事件格式、看評測結果、決定下一步要拿掉哪些機制。時間有點趕,但很有趣。
跑評測是很花 token 的事:每改一版推理規則,就要把整個題庫重跑一次,還要拿單次呼叫的 baseline 來對照。主辦方送了每位成員 40 美金的 token 額度,我們就輪流用各自的額度跑評估,一個人的額度快用完了,就換另一個人接著跑。
這個專案讓我體會到前端在 AI 系統裡的角色:不只是把結果顯示出來,而是讓推理過程可以被看見、被檢查。介面從一開始的「圓桌會議」改成後來的軟木板偵探板,三級強度矩陣也讓人一眼看出每位嫌疑人卡在哪個面向。後來分析錯題時,這些畫面本身就成了除錯工具。
而最大的收穫也是學會誠實面對評測結果。多 Agent 看起來很厲害,但對照實驗告訴我們,真正的進步來自推理規則。或許是把這發現真實地寫出來,才讓文章拿到了獎。